エージェントが実装を終えて、テストも通った。次にレビューするとき、何を見ればよいでしょうか。
機能が動くかどうかに加えて、気になることがあります。条件分岐を増やしすぎていないか。不要なコードを残していないか。既存の処理をコピーしていないか。小さな変更のために、関係のないモジュールまで巻き込んでいないか。
こうした点を、すべてのファイルを読み直して確認するのは大変です。静的解析を使うと、それぞれの疑問に対応する手がかりを集められます。ただし、レポートに「複雑度7」「重複あり」と出ても、それだけでは直すべきか分かりません。
静的解析の指標は、コードに点数をつけるためではなく、レビューで何を確かめるべきかを見つけるために使います。 この記事では、4つの観点について、解析のかけ方、結果の読み方、その後の判断までを説明します。
まず、何を調べたいのかを分ける
| 確認したいこと | 見る指標・検出結果 | レビューで確かめること |
|---|---|---|
| 処理を複雑にしすぎていないか | 関数ごとの複雑度 | 分岐は本当に必要か。複数の仕事が混ざっていないか |
| 不要なコードが残っていないか | 到達不能コード、未使用ファイル・定義 | 削除できるか。解析で見えない呼び出しがないか |
| 同じ処理を増やしていないか | コードクローンの組、重複率 | 仕様変更やバグ修正を複数箇所で行うことにならないか |
| 変更の影響を広げすぎていないか | 結合度、依存先・参照元、循環依存 | その依存は役割に合っているか。どこまで影響を確認すべきか |
以下では、私たちが開発しているpolyscanと、Python向けのpyscnを使います。まずリポジトリのルートで全体を解析すると、各項目をまとめて確認できます。
npx polyscan analyze .   # JavaScript / TypeScript、Go、Rust、C++
uvx pyscn analyze .      # Python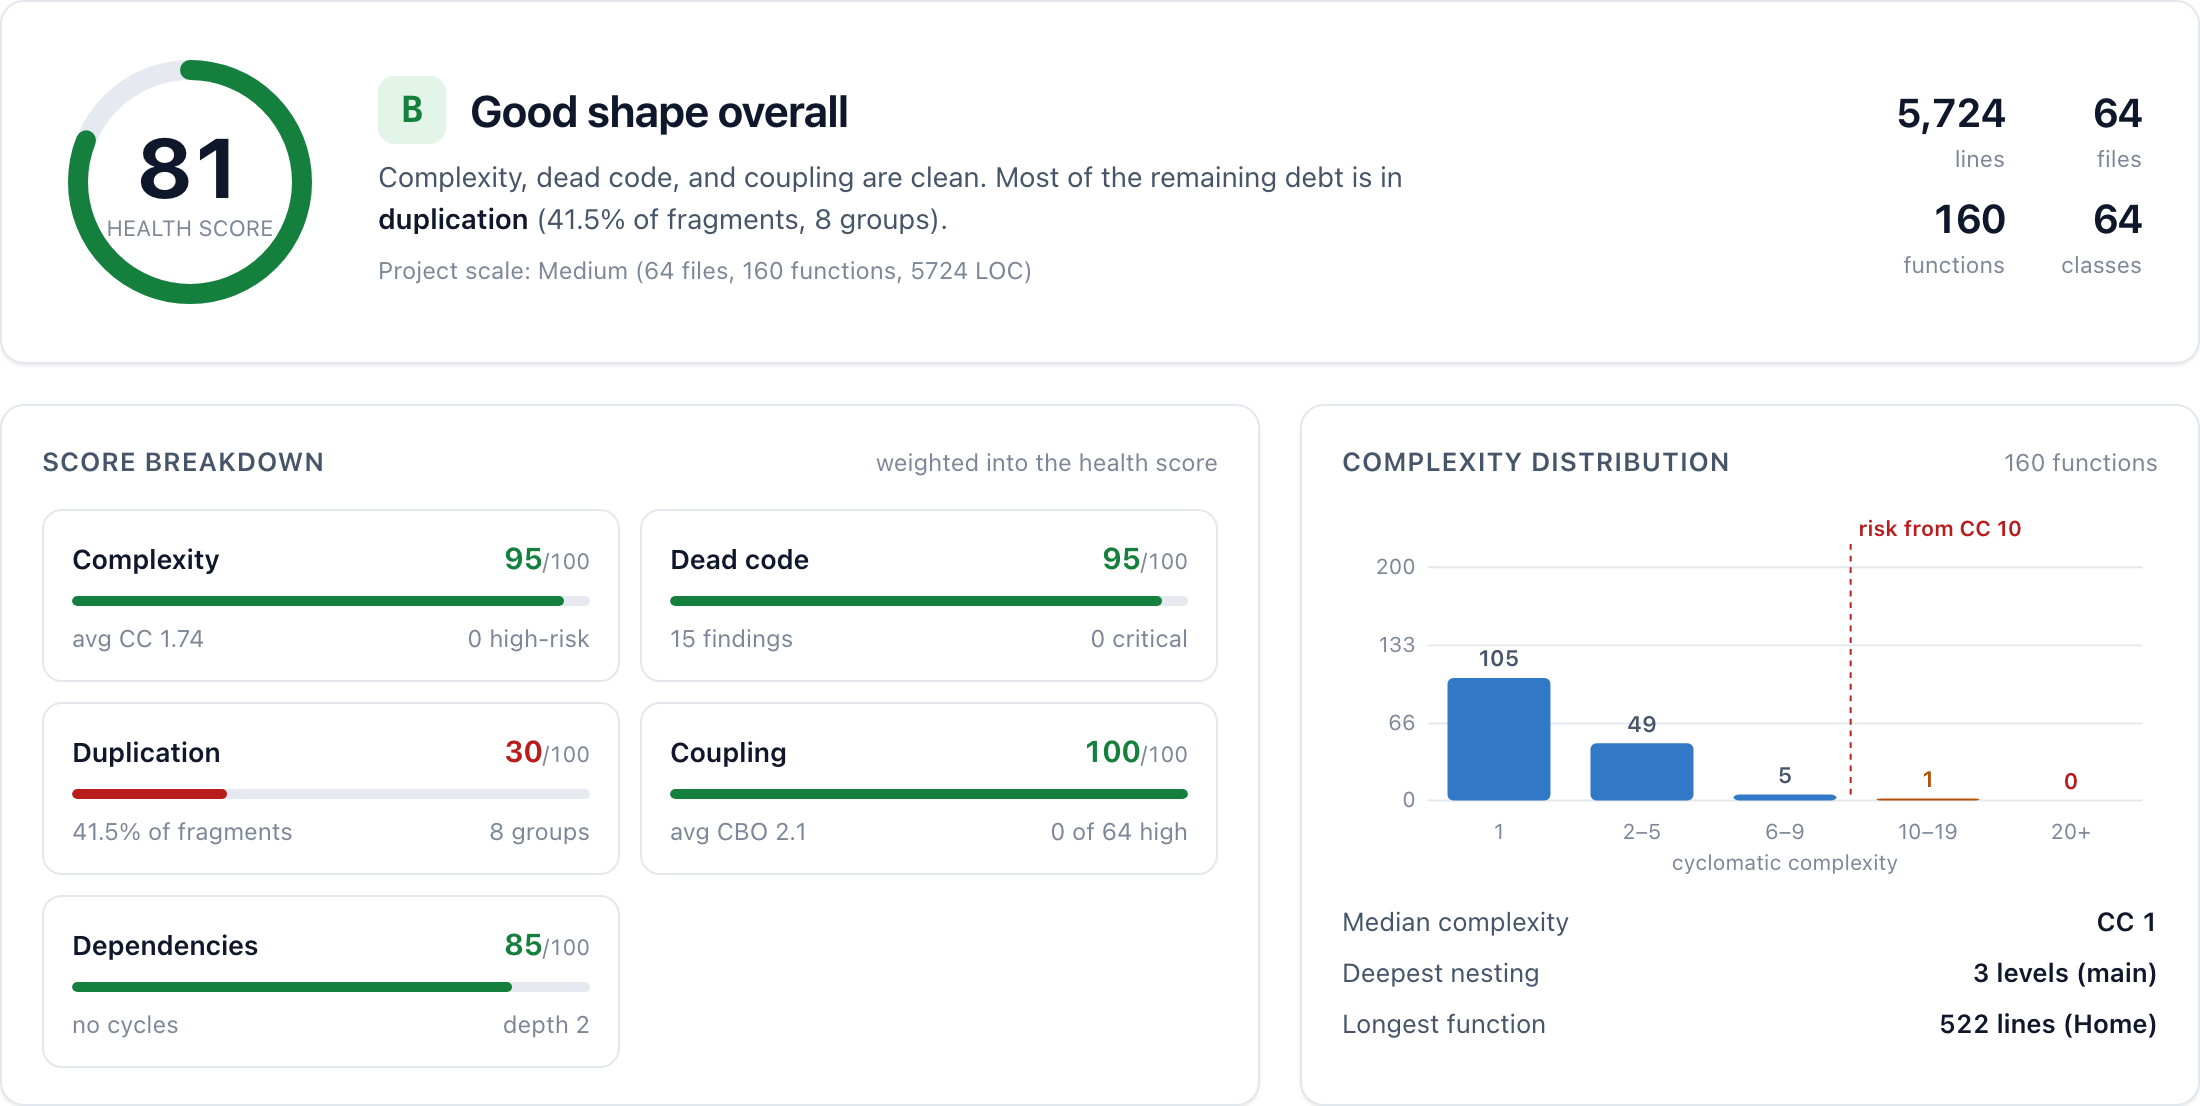
利用できる解析項目は言語によって異なります。以下の項目別コマンドはJavaScript / TypeScript向けのpolyscanの例です。Pythonでは、上のpyscnのレポートで対応する項目を確認できます。
どの項目でも、解析の対象はリポジトリ全体にします。変更したファイルだけを見ると、呼び出し元やコピー元を取りこぼします。
1. 複雑度:どの関数の分岐を読み直すか
複雑度を見る目的は、条件分岐が集中していて、動作を追ったりテストケースを考えたりするのに手間がかかる関数を探すことです。
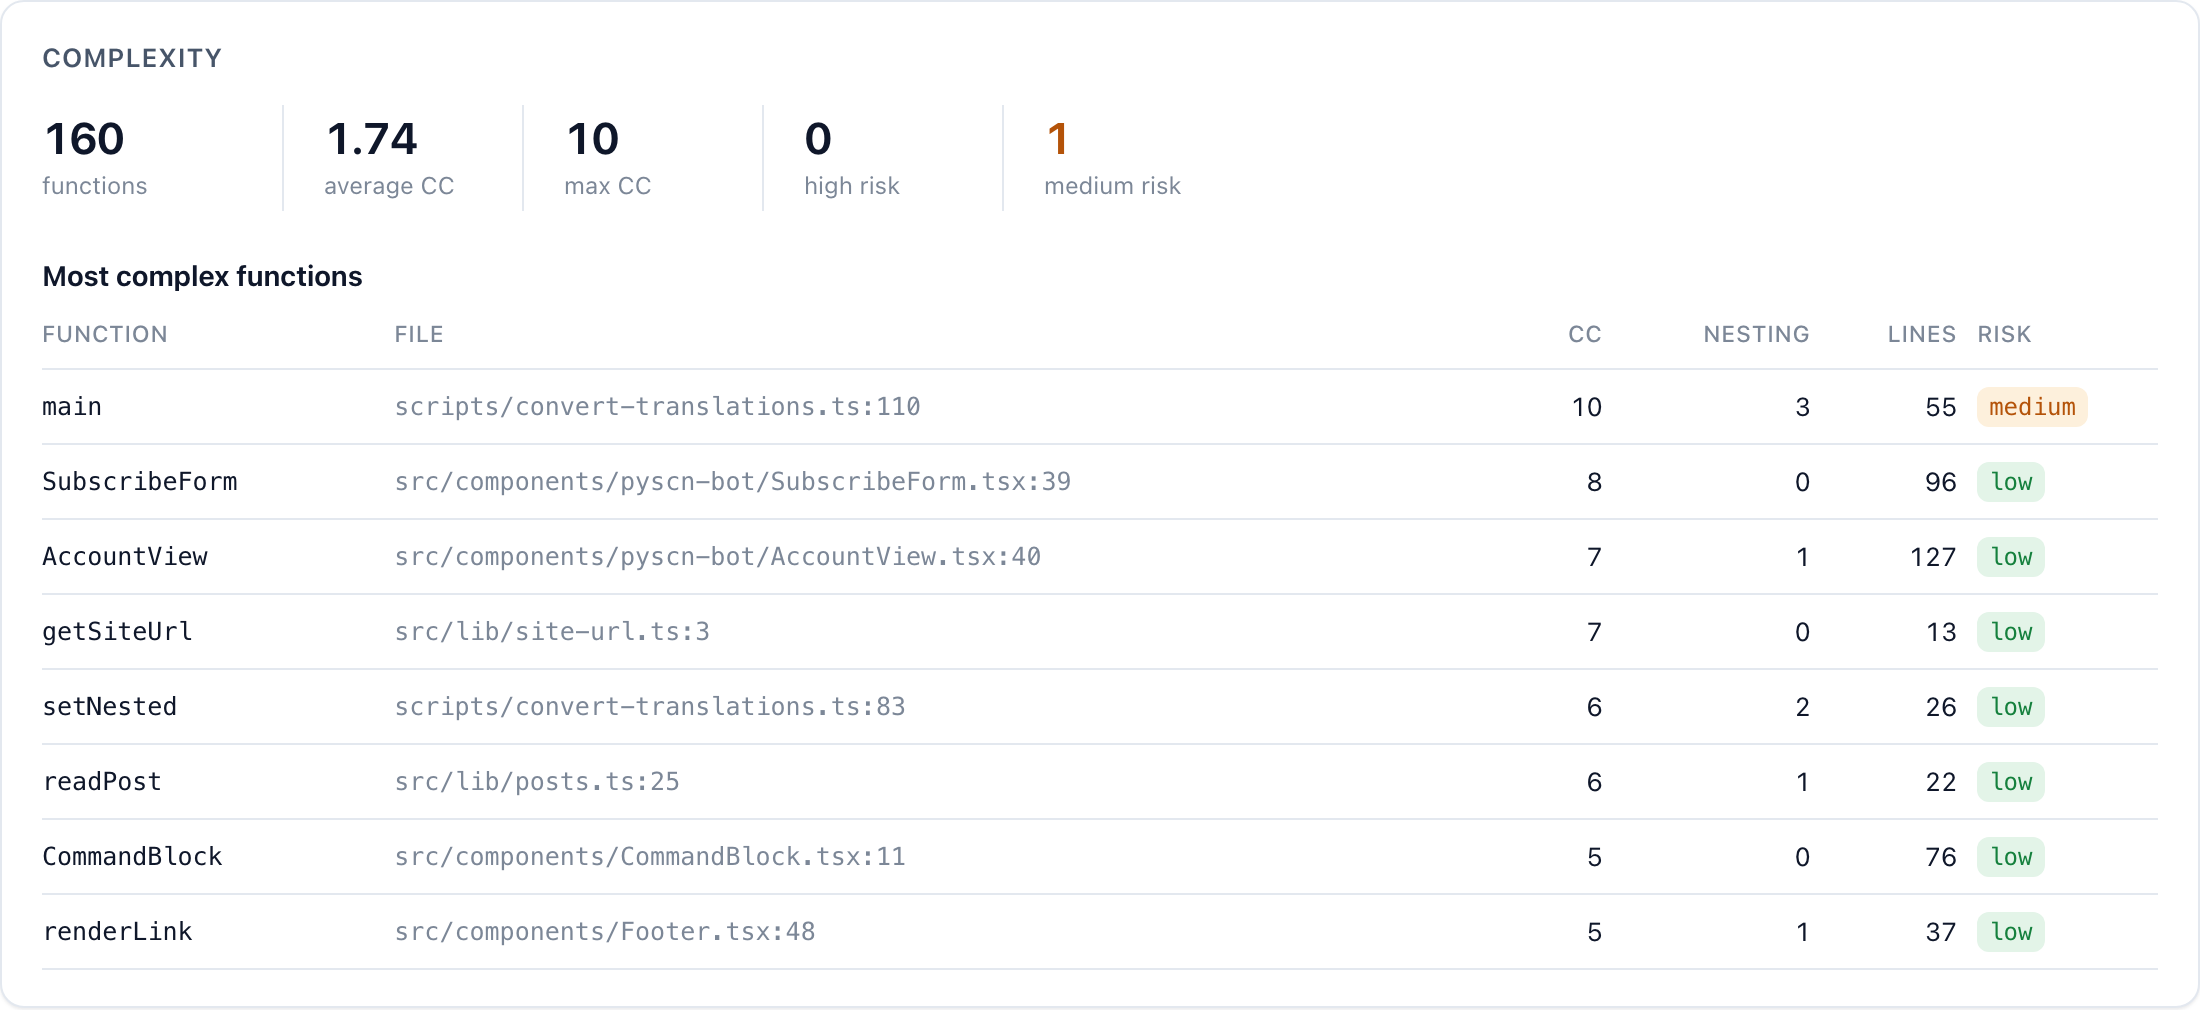
npx polyscan analyze --select complexity .ここで見るサイクロマティック複雑度は、制御フロー上の分岐を数える指標です。ネストの深さや変数名の分かりやすさまで表すものではありません。まず関数ごとの値を見て、変更した関数や、変更前より値が増えた関数を開きます。リポジトリ全体の平均だけでは、一部に集中した複雑さを見落とします。
例えば、このサイトのURLを返す関数は、13行で複雑度7でした。
export function getSiteUrl() {
  return (
    process.env.SITE_URL ??
    process.env.NEXT_PUBLIC_SITE_URL ??
    (process.env.VERCEL_PROJECT_PRODUCTION_URL
      ? `https://${process.env.VERCEL_PROJECT_PRODUCTION_URL}`
      : undefined) ??
    (process.env.VERCEL_URL
      ? `https://${process.env.VERCEL_URL}`
      : undefined) ??
    DEFAULT_SITE_URL
  ).replace(/\/$/, "");
}
この数値だけで「複雑すぎる」とは言えません。ただ、URLを1つ返すために、4つの環境変数と既定値を順番に試していることには気づけます。
ここで確かめたいのは、「本番環境ではどの値を使うのか」「複数設定されていたら、この優先順位でよいか」「値が欠けたとき、既定値で続けてよいか」です。すべて必要な分岐なら、残して、その振る舞いをテストするのが適切です。もう使わない環境への対応があれば、削れます。
関数を細かく分割すれば、1関数あたりの値は下げられます。しかし、同じ判断を複数の関数に散らしただけでは、読む人の負担は減りません。値を下げる前に、何のための分岐が増えたのかを確認します。
2. デッドコード:何を残す必要があるか
分岐の多さを確認したら、次はそもそも実行されない処理や、使われていないファイルがないかを調べます。
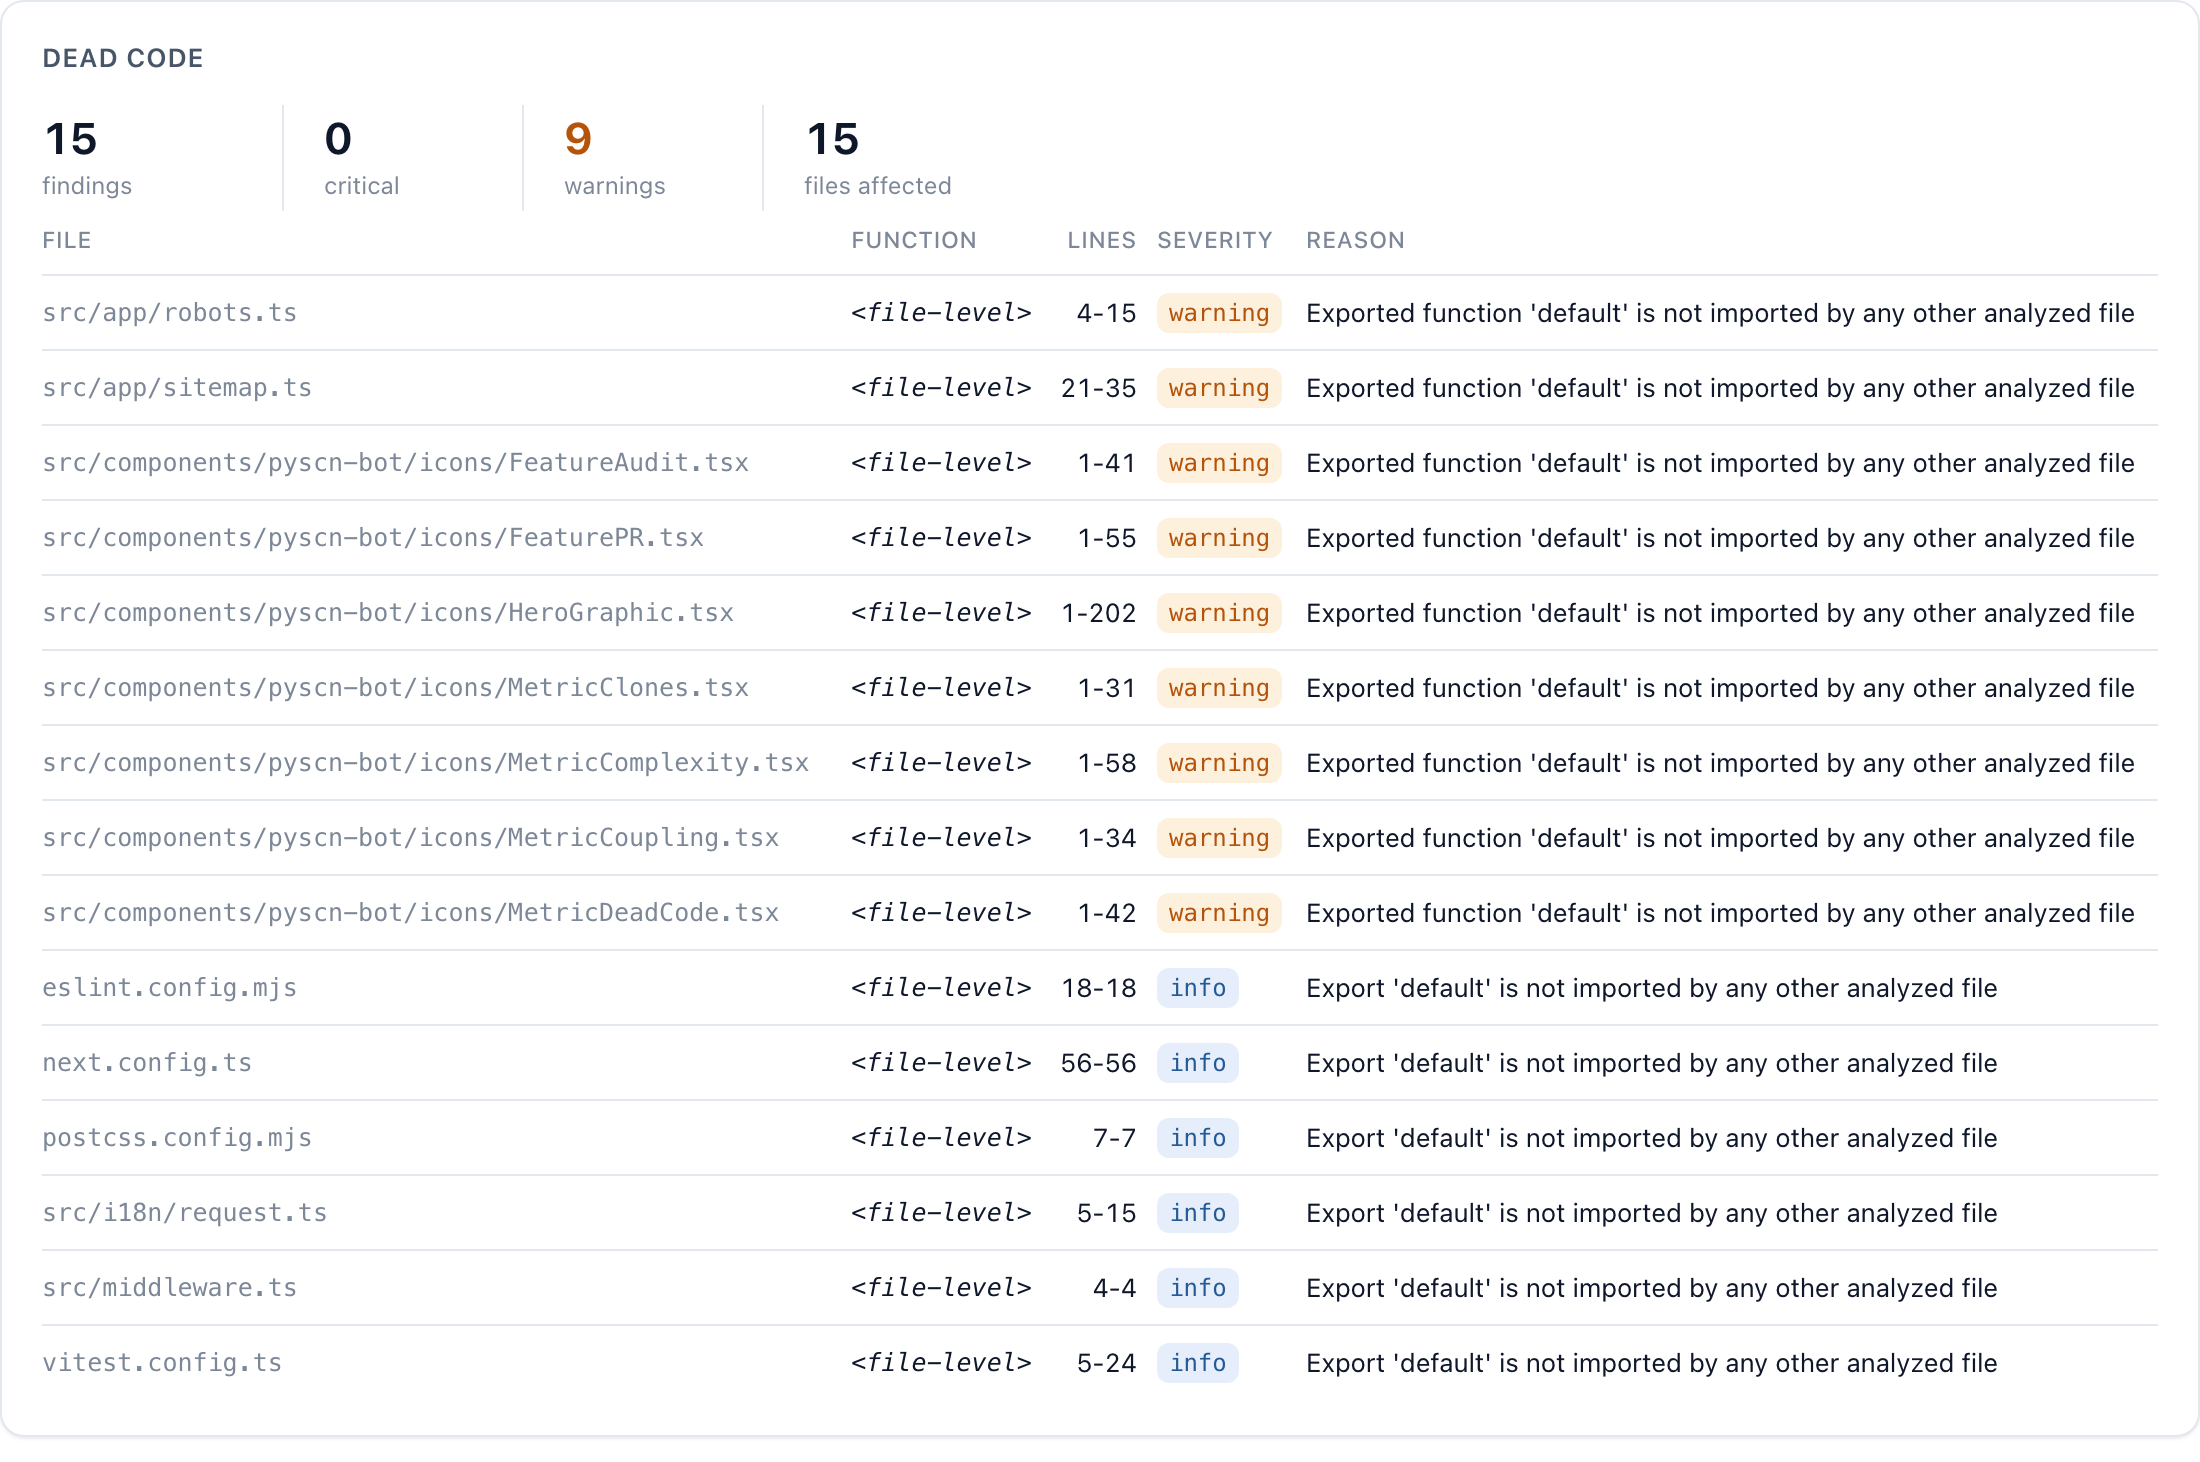
npx polyscan analyze --select deadcode .ここでは、2種類の検出を区別すると結果を読みやすくなります。1つは、無条件の return のあとにある処理のような、到達不能コードです。これは関数内の制御フローをたどって調べます。もう1つは、どこからも参照されていない未使用の定義やファイルです。こちらは、呼び出しやimportなどの参照関係を調べます。
未使用ファイルの検出は、呼び出し元が解析対象に入っていないと、使われているものまで未使用に見えてしまいます。ここでも全体を解析します。
このサイトでは、未使用の候補が15件報告され、そのうち7つが実際に不要なファイルでした。合わせて463行です。6つは、エージェントがトップページを作り直した際に不要になったアイコンです。importは削除されていましたが、ファイル自体は残っていました。残りの1つは、旧サイトからコピーされ、一度も使われなかった画像でした。
ファイルが残っていても、ページは正常に表示されます。差分に見えるのは、importを消した行だけです。そのため、32本のプルリクエストがマージされる間も、ファイルは残ったままでした。リポジトリ全体の参照関係を調べることで、ようやく見つかりました。
残りの8件は、robots.ts などNext.jsがファイル名の規約に従って読み込むファイルと、ESLintやVitestなどのツールが読む設定ファイルでした。「参照が見つからない」は「削除してよい」と同じではありません。公開API、フレームワークの規約、動的な読み込みなどを確認してから削除します。
また、不要なものが必ずこの項目で見つかるわけでもありません。このサイトにあった一回きりの翻訳変換スクリプトには、複雑度の指摘を読んだことで気づきました。翻訳の移行はすでに終わっていたのですが、その事情は制御フローや参照関係だけでは分かりません。7つのファイルとこのスクリプトは、この記事と同じプルリクエストで削除しました。
3. 重複:同じ修正を何度もすることにならないか
不要なコードがなくても、必要な処理をあちこちにコピーしていれば、保守の手間は増えます。それを調べるのがコードクローン検出です。
npx polyscan analyze --select clone .polyscanは、関数の構造を比較して、同じコードやよく似たコードをグループとして報告します。単純な文字列検索と違い、変数名を変えたり、一部の処理を追加したりしたコピーも候補になります。詳しい仕組みは重複コードの検出についての記事にまとめています。
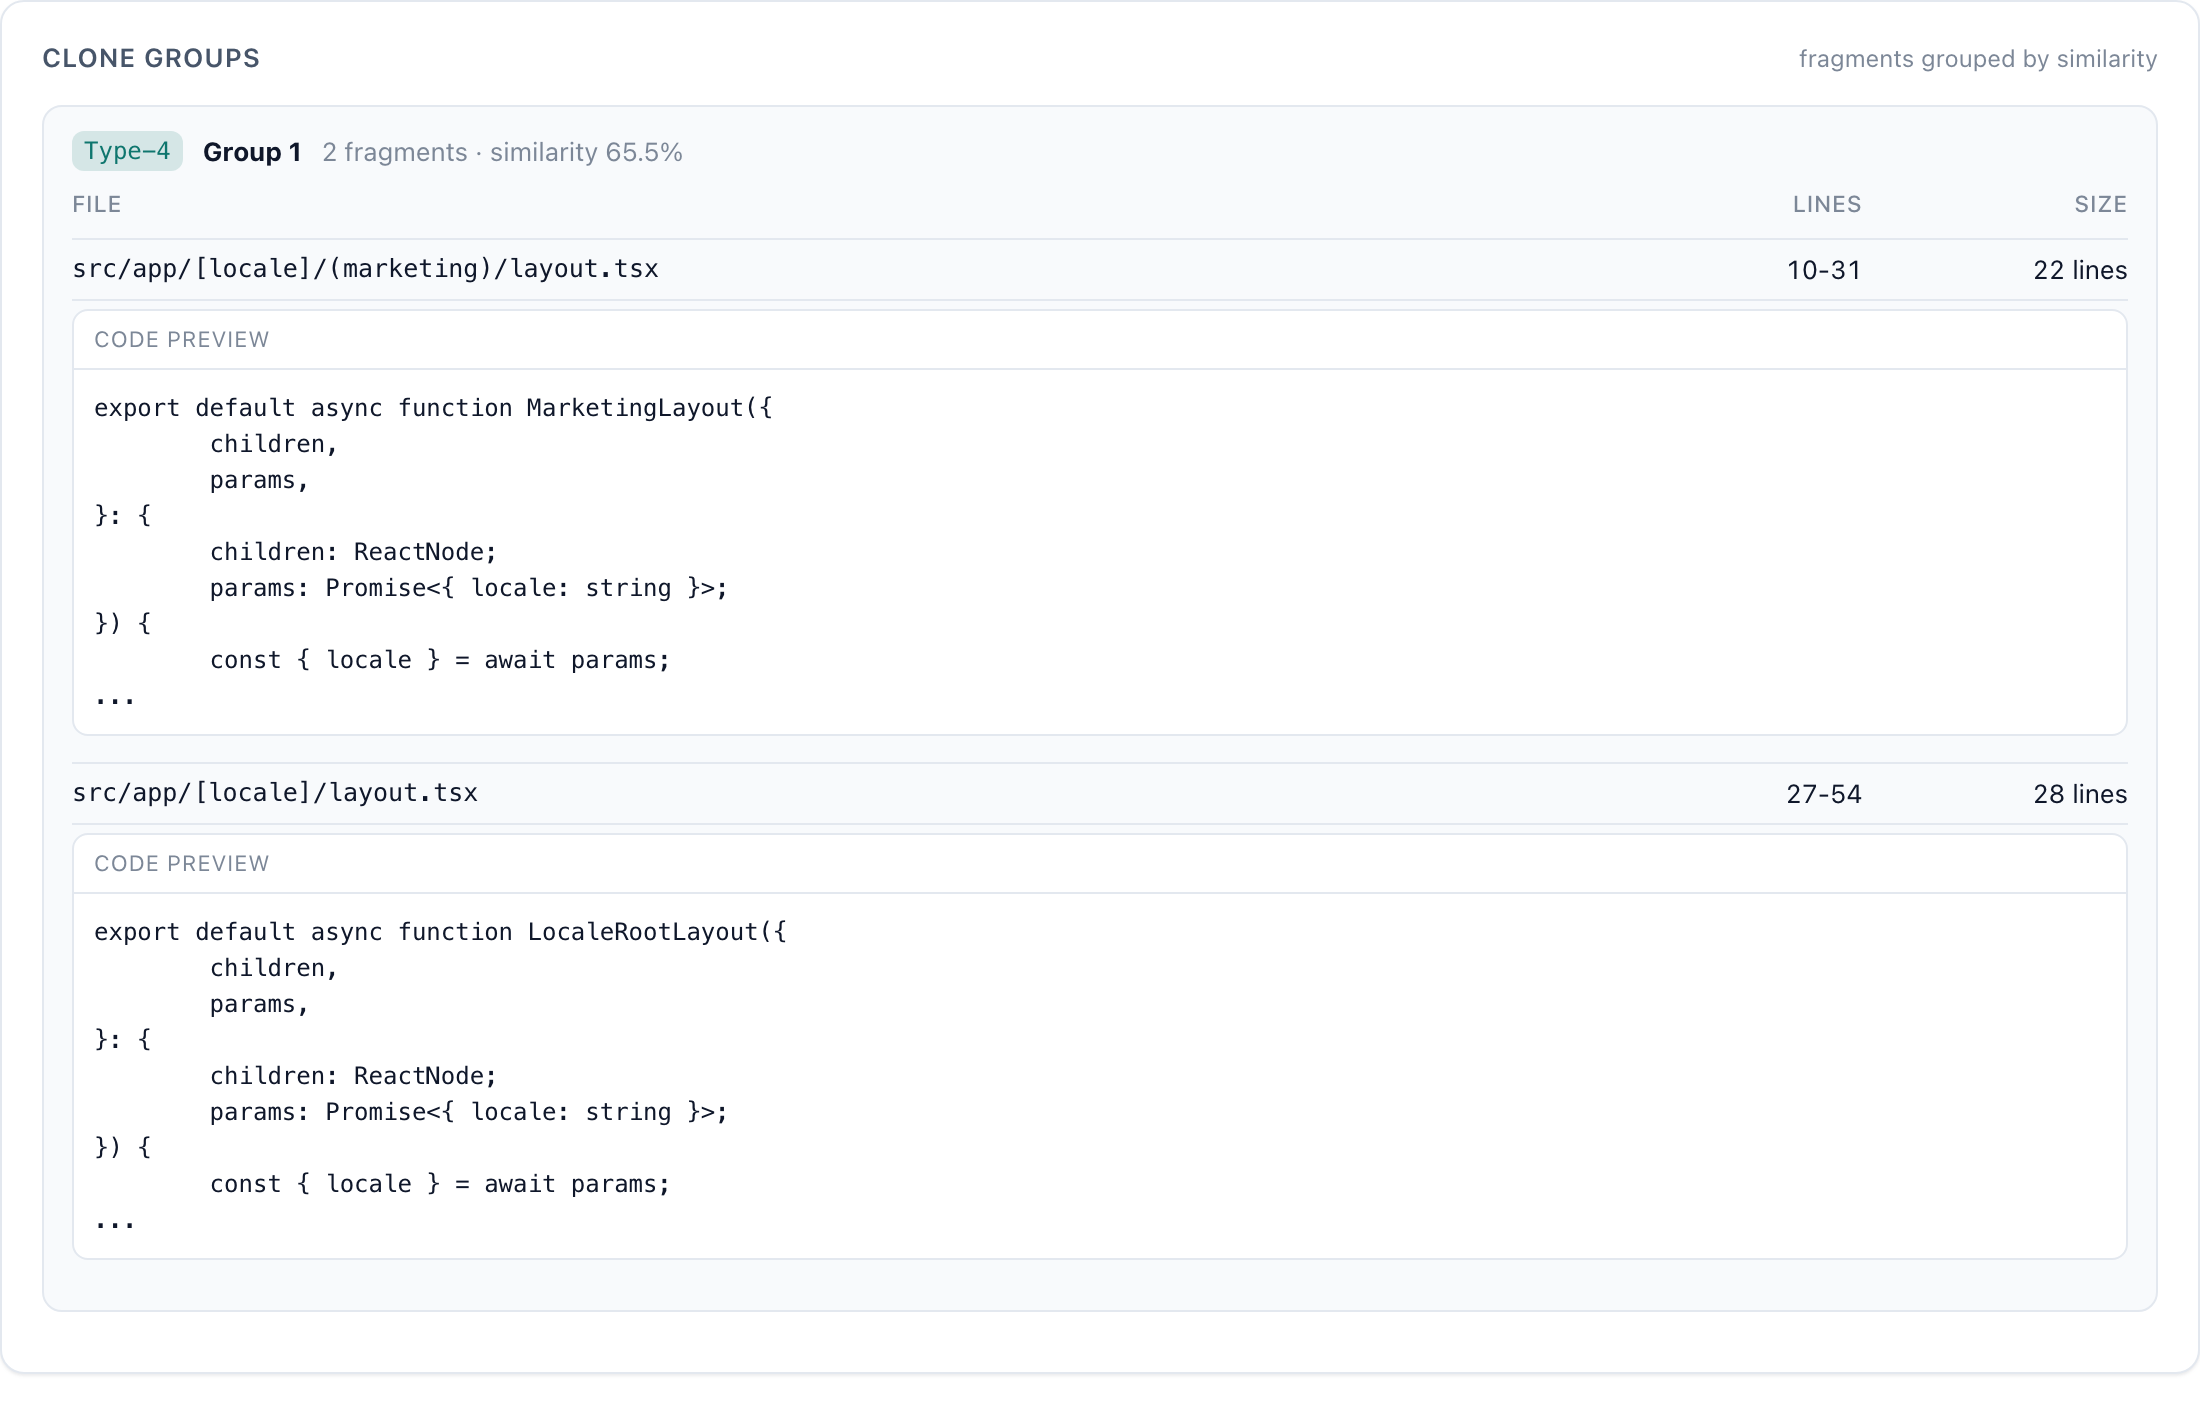
最初に見るのは、リポジトリ全体の重複率よりも、今回の変更で増えたクローンの組です。コピー元は変更ファイルの外にあることが多いので、ここでも全体を対象にします。
説明用の例として、注文取得と顧客取得の2つの関数を考えます。どちらもAPIを呼び出し、同じリトライ処理を行い、結果をそれぞれの型に変換しているとします。リトライに不具合が見つかったとき、両方を直す必要があるなら、その部分を共有する意味があります。
一方、構造が似ていても、注文と顧客で今後の仕様が別々に変わるなら、関数全体をまとめると条件分岐が増えるかもしれません。見るべきなのは「何行減らせるか」ではなく、「同じ理由で一緒に変更する処理か」です。
生成コードやテスト用データなど、意図的な重複もあります。重複率をゼロにしようとするより、修正漏れにつながるコピーから対処します。
4. 依存関係と結合度:どこまで影響を確認するか
個々の関数が単純で重複もなくても、多くのモジュールに依存していれば、その関数だけ読んで変更の影響を判断するのは難しくなります。そこで、コード同士のつながりを調べます。
npx polyscan analyze --select deps .  # モジュール間の依存関係
npx polyscan analyze --select cbo . # クラス・型の結合度依存関係の解析では、どのモジュールがどのモジュールを読み込むかをグラフとして捉えます。A → B → C → A のような循環があれば、関係するファイルを開いて、どのimportが輪を閉じているかを確認します。循環があるだけで実行時エラーになるとは限りませんが、読み込み順序や役割分担を確認するきっかけになります。
結合度の指標であるCBO(Coupling Between Objects)は、クラスや型が参照する他の型の数を測ります。何を依存として数えるかは、言語や解析ツールで異なります。値が大きければ、理解するときに確認する相手が多い、という手がかりになります。
以前の解析では、polyscanのJavaScript向け重複検出器の結合度が22、Go・Rust・C++向けの検出器が18でした。依存先を比べると、どちらも構文木の比較、フィンガープリント、グループ化など、ほぼ同じ部品を組み合わせていました。数値を見ただけでは分からなかった設計の重なりが、依存先の一覧を読むと見えてきました。
ただし、多くの部品を組み合わせる役割のクラスなら、結合度が高くなるのは自然です。同じ数値でも、小さな変換用ヘルパーなら依存が多すぎるかもしれません。「この役割に、この依存先が必要か」を確かめます。
変更の影響を考えるときは、依存先だけでなく、変更対象を使っている側も見ます。多くの場所から使われる型の変更なら、呼び出し元やテストを広く確認する必要があります。
指標が良くても、振る舞いは別に確かめる
ここまでの4つの観点は、コードのどこを詳しく読むかを決めるのに役立ちます。ただし、指摘がないことは、要求どおりに動くことの保証にはなりません。
Python製の add-skills には、次のエラー処理がありました。
try:
    with open(skill_file, encoding="utf-8") as f:
        post = frontmatter.load(f)
except (OSError, yaml.YAMLError):
    return None
設定ファイルの読み込みに失敗すると None を返し、呼び出し側は「スキルがない」と扱います。実際に SKILL.md のYAML設定から閉じ引用符を1つ消すと、設定の誤りを知らせるメッセージではなく「No skills found」と表示されました。
pyscnでは、この関数は複雑度3で低リスクと判定され、ruffを全ルール有効で実行しても、この振る舞いへの指摘はありませんでした。処理は単純でも、ユーザーには何を直せばよいか伝わりません。
この問題を確認するには、「壊れた設定を渡したら、ファイル名と原因を知らせる」という期待を決め、実際の動作やテストで確かめる必要があります。複雑度、重複率、結合度のどれを下げても、それだけでは解決しません。
エージェントの作業に組み込む
実際の開発では、変更前の解析結果を残し、作業後にもう一度実行して比べると、読むべき箇所を絞りやすくなります。比べるときは、ツールのバージョン、設定、対象範囲を揃えます。生成コードや外部ライブラリを含めるかどうかが変わると、自分の変更とは無関係に値が動いてしまうからです。初回のレポートにある過去の問題を一度に直すより、今回増えた分岐、未使用ファイル、新しいコピー、追加された依存から確認します。
エージェントにも、単に「品質を改善して」ではなく、次のように頼めます。
変更前後でリポジトリ全体を解析し、今回増えた複雑度、未使用コード、重複、依存関係を確認してください。各指摘について、該当コードと、修正するか残すかの理由を示してください。エラー時の振る舞いは、要求に照らして別に確認してください。
polyscanとpyscnは、コーディングエージェントから直接呼び出せます。過去の変更で残った問題を拾うには、定期的な全体解析も役立ちます。GitHub Appの Polyscan はデフォルトで毎週解析し、AIエージェントが重要な指摘に関連するコードを読んだうえで、直すべき点をGitHub Issueにまとめます。公開リポジトリは無料です。
レビューで欲しいのは「値が良くなった」という報告よりも、「この分岐は不要だった」「このコピーは同時に修正する必要がある」といった判断です。静的解析は、その判断に必要な場所を見つけるために使います。
出典・参考:
- 本記事の計測:このサイト(polyscan-app)の
24ea613をpolyscan 0.6.0で、add-skillsの26dd058をpyscn 1.32.5とruff 0.17.1で計測。ruffの--select ALL以外はすべてデフォルト設定です。 - 重複検出器の結合度は依存関係の記事から引用。polyscan 0.5.0のソースを0.5.1で計測しています。
- コマンドと対応言語:polyscan CLI、pyscn。